
Votre agent IA ne sait pas compter
Un agent qui fouille vos transcripts trouve des exemples. Pour répondre de façon fiable à une question de pilotage, il lui faut des champs structurés, et les concevoir, c'est le métier des RevOps.

Un agent qui fouille vos transcripts trouve des exemples. Il ne sait pas répondre de façon fiable à une question de pilotage. Pour ça, il lui faut de la donnée structurée, et la concevoir, c'est le métier des RevOps.
Les assistants IA lisent désormais vos appels, votre CRM et vos emails. Sur « montre-moi ce que les clients disent du prix », ils sont bluffants. Sur « combien de deals, pour quel montant », ils se trompent avec la même assurance.
Voici d'où vient l'écart, ce que mesurent deux études récentes, et la méthode pour concevoir et calibrer vos premiers champs.
Une question, deux réponses
Posez à un agent IA une question que vous posez chaque semaine : « Combien de deals ouverts ce trimestre citent le Concurrent A comme alternative, et pour quel montant ? »
Selon la façon dont l'agent accède à vos données, vous obtiendrez deux réponses très différentes. Les deux seront formulées avec la même assurance. Une seule sera juste.
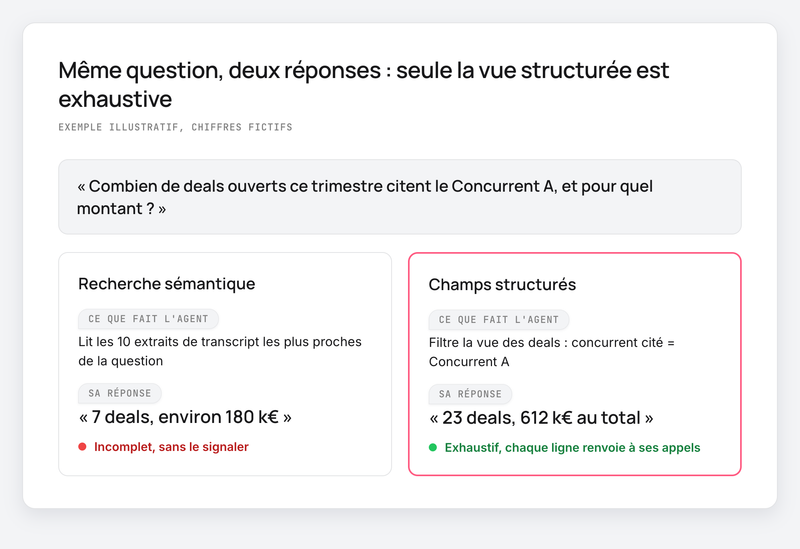
La réponse de gauche est le fonctionnement normal de la recherche sémantique. C'est aussi ce qui la rend dangereuse pour le pilotage : rien dans la réponse ne signale qu'elle est incomplète.
Nous avons fait le test sur nos propres appels. À la question « quels deals ont vu un concurrent cité en appel ? », une recherche dans les transcripts qui renvoie les 10 passages les plus proches a retrouvé 5 % des deals qu'un comptage complet dans une vue identifiait. En élargissant à 50 passages, elle n'en retrouvait encore que 13 % (données d'appels Claap, T3 2026).
Notre centre d'aide décrit le même écart sur une question de coaching. Face au dossier brut des enregistrements, l'agent a dû choisir un petit échantillon de transcripts. Face à une vue structurée, il a lu chaque ligne et sorti un score moyen par commercial et par critère SPICED (centre d'aide Claap).
Le bibliothécaire et le catalogue
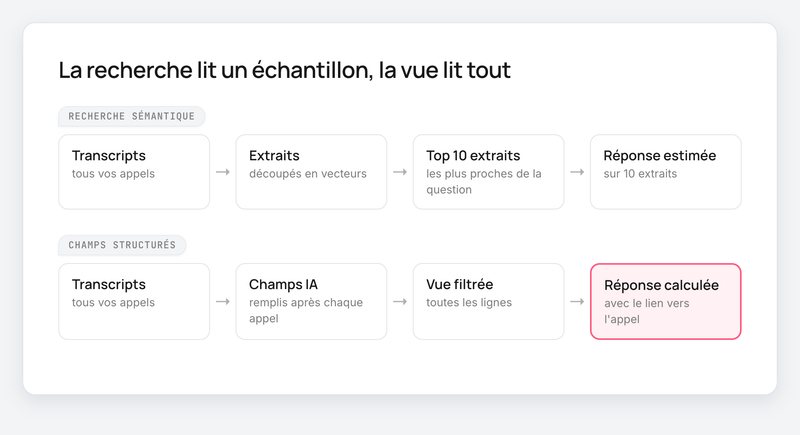
La recherche sémantique ressemble à un bibliothécaire très cultivé. Vous lui demandez « des livres qui parlent du Concurrent A », il vous apporte les dix plus proches de votre question. Il s'arrête là.
Techniquement, c'est le principe du top-k : chaque passage de transcript est transformé en vecteur, et l'agent récupère les k passages les plus proches de la question. Il lit ces extraits, puis il rédige une réponse. Dans notre exemple fictif, s'il y a 23 deals concernés et qu'il n'en voit que 7, il répondra 7.
La donnée structurée ressemble au catalogue de la bibliothèque. Chaque livre a une fiche avec auteur, année et genre. Pour répondre à « combien de romans publiés après 2010 », on filtre les fiches, sans ouvrir un seul livre.
Trois types de questions cassent la recherche sémantique, et ce sont exactement celles d'un RevOps :
- Compter et additionner. « Combien de deals », « quel montant total ». Le LLM additionne ce qu'il voit, et il ne voit qu'un échantillon.
- Filtrer avec plusieurs conditions. « Owner = Marie, stage = closing, concurrent cité = Concurrent A ». Les embeddings ne font pas de logique booléenne.
- Exclure. « Les deals où le budget n'a pas été validé ». La négation est un point faible connu des embeddings : « budget validé » et « budget pas validé » sont très proches sémantiquement.
Ce que disent les chiffres
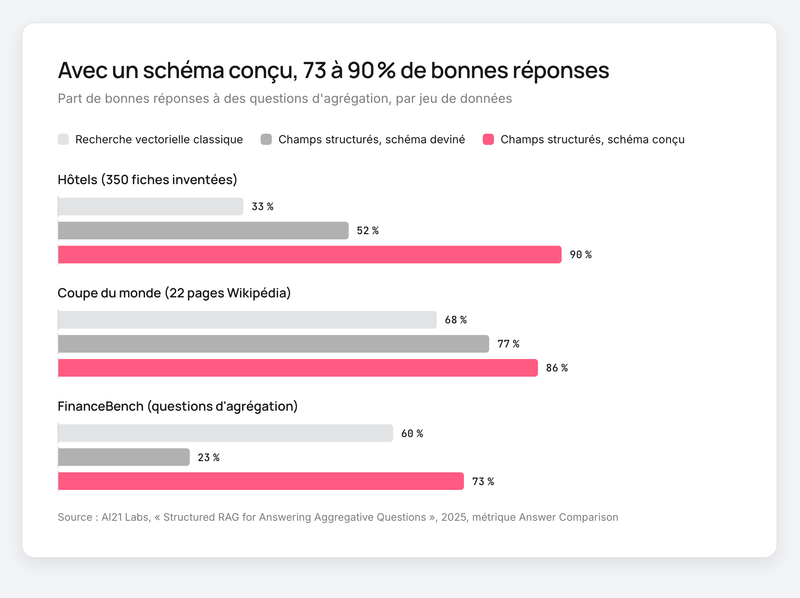
Sur des questions d'agrégation, passer d'une recherche vectorielle à une requête sur des champs bien conçus fait passer de 33 % à 90 % de bonnes réponses, dans le test le plus propre de l'étude Structured RAG d'AI21 Labs.
TAG (UC Berkeley et Stanford, CIDR 2025). Les chercheurs ont posé 80 questions réalistes à des systèmes IA branchés sur des bases de données (Biswal et al., 2025).
- Dans l'étude TAG, aucune méthode standard ne dépasse 20 % de bonnes réponses : la meilleure, Text2SQL, plafonne à 17 %.
- Le RAG classique ne répond juste à aucune des questions de l'étude TAG, parce qu'il laisse le LLM faire seul les comptages, les calculs et les filtres.
- L'approche qui combine LLM et requêtes sur la base atteint 55 % dans l'étude TAG : 53 % sur les questions qui demandent des connaissances, 60 % sur celles qui demandent du raisonnement.
Structured RAG (AI21 Labs, 2025). L'équipe compare la recherche vectorielle classique à une approche qui extrait des champs à l'ingestion, puis répond en SQL (Koshorek et al., 2025).
- Le test le plus parlant porte sur 350 fiches d'hôtels inventées, que le modèle ne peut pas connaître d'avance : la recherche vectorielle y répond juste à 33 % des questions, les champs structurés avec un schéma conçu à 90 % (étude Structured RAG d'AI21 Labs).
- Sur les trois jeux de données de l'étude d'AI21 Labs, le schéma conçu donne entre 73 % et 90 % de bonnes réponses.
- Avec un pipeline simple, l'écart se creuse encore. Lors d'une démonstration sur 22 pages Wikipédia consacrées aux Coupes du monde, un pipeline RAG d'initiation répondait juste à 5 % des questions d'agrégation, et l'API Responses d'OpenAI à 11 % (AI21 Labs, AI Engineer World's Fair 2025).
Les modèles connaissent déjà une partie de l'histoire des Coupes du monde, ce qui gonfle le score de la recherche vectorielle sur ce corpus (68 % dans l'étude d'AI21 Labs). Le jeu d'hôtels inventés reste donc le test le plus fiable. Ces benchmarks portent sur des données publiques ou synthétiques : ils prouvent le principe, et le gain exact sur vos propres appels reste à mesurer.
Le vrai facteur : la qualité des champs
Avoir une base de données ne suffit pas. Dans l'étude d'AI21 Labs, quand le modèle devine lui-même le schéma, la précision retombe entre 23 % et 77 % selon les jeux de données. Sur les questions financières de FinanceBench, elle passe de 73 % avec un schéma conçu à 23 % avec un schéma deviné, d'après la même étude d'AI21 Labs : même architecture, même modèle, seul le schéma change.
L'exemple donné par les auteurs parle à tout RevOps : un champ « dépenses d'investissement » décrit en une ligne a enregistré deux valeurs à 1, l'une en millions, l'autre en milliards (AI21 Labs, 2025).
C'est la partie que les discours sur les agents IA oublient. Un agent vaut exactement ce que valent les champs qu'on lui donne à lire. Un champ mal défini produit des chiffres faux, avec une apparence de précision.
Or définir les bons champs, c'est déjà le métier des RevOps :
- savoir quelles décisions le business doit prendre (forecast, priorisation, coaching) ;
- traduire ces décisions en propriétés, avec des valeurs fermées ;
- garantir que la donnée reste propre dans le temps.
La seule chose qui change avec l'IA, c'est qui remplit les champs. Avant, c'était le commercial, quand il y pensait. Dans les données d'appels Claap et de deals HubSpot du T3 2026, 53 % des deals où un acheteur a cité en appel un outil d'enregistrement concurrent n'avaient aucune valeur correspondante dans le champ concurrent du CRM. Maintenant, un modèle peut les remplir à partir de ce qui s'est dit en appel. Le RevOps reste dans l'équation : il en devient la pièce centrale.
Comment Claap applique ce modèle
Petite précision : Claap est notre produit.
Claap transforme chaque appel en données structurées que vos équipes et vos agents peuvent requêter. Le principe tient en quatre briques.
- Des champs IA que vous définissez. Sur les réunions, les deals et les entreprises, vous créez les champs dont votre pilotage a besoin : concurrent cité, budget validé, objection principale, prochaine étape. Le modèle les remplit à partir de la conversation (AI Context Layer).
- Des vues pour filtrer et compter. Les champs se combinent dans des vues, comme dans un CRM : tous les deals en closing qui citent le Concurrent A, triés par montant. La réponse est la liste complète.
- La synchro avec votre CRM. Chaque champ peut écrire dans la propriété HubSpot ou Salesforce de votre choix (remplissage du CRM). Le CRM se remplit à partir de ce qui s'est réellement dit en appel.
- Un retour à la source. Dans une vue de réunions, chaque ligne est un appel. Si un chiffre surprend, on rouvre l'appel et on vérifie.
Voici à quoi ressemble une vue Claap pour la question de départ (données fictives) :
| Deal | Stage | Montant (k€) | Concurrent cité | Budget validé | Objection principale |
|---|---|---|---|---|---|
| Acme Logistique | Closing | 48 | Concurrent A | Oui | Prix |
| Nordis Assurances | Négociation | 36 | Concurrent A | Non | Intégration CRM |
| Veltra Industrie | Démo | 22 | Concurrent A | Non | Adoption terrain |
| Kalia Santé | Closing | 61 | Concurrent A | Oui | Sécurité des données |
Données fictives, à titre d'illustration : entreprises, montants et concurrent sont inventés.
C'est cette vue que votre agent IA lit. Via le connecteur MCP de Claap, un assistant comme Claude ou ChatGPT interroge directement les vues et les champs : il lit une réponse calculée, sans deviner. Le connecteur MCP est inclus dans toutes les offres de Claap, gratuite comprise, et l'enrichissement du CRM demande l'offre Business.
Quand la recherche sémantique reste la bonne réponse
Les champs structurés ne répondent qu'aux questions qu'on a anticipées. Pour le reste, la recherche dans les transcripts reste indispensable, et Claap propose les deux.
| Votre question | Le bon outil | Pourquoi |
|---|---|---|
| Combien, lesquels, quel montant ? | Champs + vues | Réponse exhaustive et calculée |
| Comment évolue ce chiffre mois après mois ? | Champs + vues | Même définition à chaque période |
| Montre-moi où le client le dit | Recherche dans les transcripts | Le verbatim exact, en contexte |
| Est-ce que quelqu'un a déjà parlé de tel sujet ? | Recherche dans les transcripts | Exploration sans champ prévu |
| Un nouveau sujet revient souvent | Recherche, puis nouveau champ | On explore, puis on structure |
La dernière ligne est la plus importante. La recherche sert à découvrir ce qui mérite d'être suivi. Le champ sert à le suivre de façon fiable.
Utilisez des champs et des vues quand la réponse finit dans un forecast, un tableau de bord ou une décision de priorisation, parce qu'il faut la même définition d'une semaine à l'autre. Gardez la recherche dans les transcripts quand vous cherchez une citation ou un sujet que personne n'a encore nommé. Ce conseil ne vaut pas pour une équipe de trois commerciaux avec vingt deals ouverts : à cette échelle, relire les deals un par un va plus vite que concevoir un schéma.
Concevoir vos 5 premiers champs
Un bon champ part d'une décision. Pour chaque champ, répondez à ces cinq questions avant de le créer :
- Quelle décision alimente-t-il ? Forecast, priorisation d'un deal, coaching d'un commercial. Sans décision, pas de champ.
- Quel type ? Oui/non, liste fermée, nombre ou date. Gardez le texte libre pour ce que vous lirez sans le compter.
- Quelles valeurs, exactement ? Écrivez la définition de chaque valeur : « Budget validé = le décideur a confirmé un montant ». Une formule comme « le client semble avoir du budget » laisse le modèle interpréter.
- Que faire quand l'info n'est pas dans l'appel ? Prévoyez une valeur « non mentionné », sinon le modèle devinera.
- Comment le calibrer ? Avec la méthode de la double extraction, détaillée ci-dessous.
Commencez par ces cinq champs, parce qu'ils couvrent la plupart des besoins de pilotage : concurrent cité, budget validé, décideur identifié, objection principale et prochaine étape datée.
Calibrer un champ : la double extraction
La méthode la plus efficace consiste à faire tourner deux extractions indépendantes et à mesurer leur écart. Chaque désaccord révèle presque toujours une définition ambiguë.
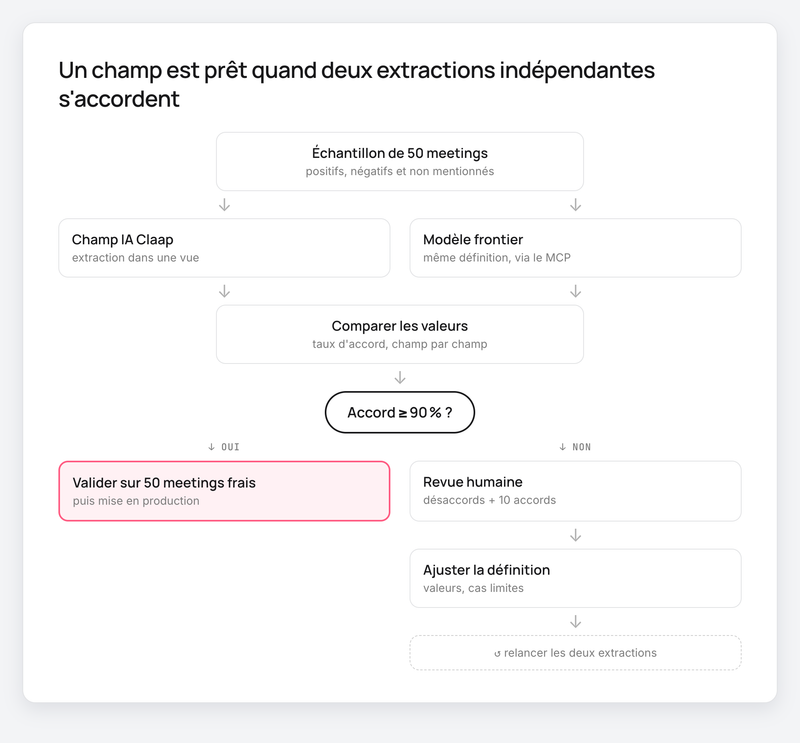
- Constituez un échantillon de 50 meetings. Équilibrez-le pour avoir assez de cas positifs, négatifs et non mentionnés. Si le Concurrent A n'apparaît que dans 5 appels, 95 % d'accord ne veut rien dire.
- Lancez deux extractions en parallèle. D'un côté le champ IA Claap dans une vue, de l'autre un modèle frontier avec exactement la même définition. Les deux se pilotent depuis le MCP de Claap.
- Mesurez l'accord, champ par champ. Fixez le seuil avant de commencer, par exemple 90 %, et plus haut pour un champ qui alimente le forecast. Pour les valeurs rares, le kappa de Cohen est plus fiable que le taux d'accord brut.
- Faites trancher les désaccords par un humain. Contrôlez aussi une dizaine de cas où les deux modèles sont d'accord : deux modèles peuvent se tromper de la même façon.
- Ajustez la définition et recommencez jusqu'à atteindre le seuil.
- Validez sur 50 nouveaux meetings. Sinon, la définition risque d'être taillée pour le premier échantillon.
Sources
- Biswal et al., Text2SQL is Not Enough: Unifying AI and Databases with TAG, CIDR 2025
- Koshorek et al. (AI21 Labs), Structured RAG for Answering Aggregative Questions, 2025
- AI21 Labs, RAG Evaluation Is Broken! Here's Why (And How to Fix It), AI Engineer World's Fair 2025
Questions fréquentes
Qu'est-ce qu'un agent IA ?
Un agent IA est un programme qui reçoit un objectif, se connecte à des outils (CRM, emails, appels) et enchaîne les actions pour l'atteindre. Pour une équipe commerciale, il prépare un rendez-vous, met à jour un deal ou répond à une question sur le pipeline. Sa fiabilité dépend des données qu'il lit.
Qu'est-ce qu'un CRM IA ?
Un CRM IA est un CRM dont une partie des champs est remplie ou exploitée par l'IA : résumés d'appels, scoring, propriétés complétées à partir des conversations. Pour le pilotage, sa valeur tient à la définition de ces champs. Un champ aux valeurs fermées se compte, un résumé en texte libre se lit.
Un agent IA peut-il remplacer un CRM ?
Non. L'agent lit et agit, le CRM garde les données sur lesquelles il calcule. Sans propriétés structurées, l'agent répond à partir d'un échantillon de textes, et ses totaux deviennent des estimations.
Pourquoi mon agent IA donne-t-il des chiffres faux ?
Le plus souvent, il compte sur un échantillon. Avec la recherche sémantique, l'agent lit les extraits les plus proches de la question, puis additionne ce qu'il a vu. Donnez-lui une vue filtrée sur des champs structurés et il lit toutes les lignes.
Faut-il arrêter la recherche dans les transcripts ?
Gardez-la pour retrouver une citation exacte ou explorer un sujet nouveau. Quand un sujet revient souvent, transformez-le en champ pour le suivre de façon fiable.
Comment savoir si un champ IA est fiable ?
Faites tourner deux extractions indépendantes sur un échantillon équilibré de 50 meetings, puis mesurez leur taux d'accord. Fixez le seuil avant de commencer, par exemple 90 %, faites trancher les désaccords par un humain, puis validez sur 50 nouveaux meetings.